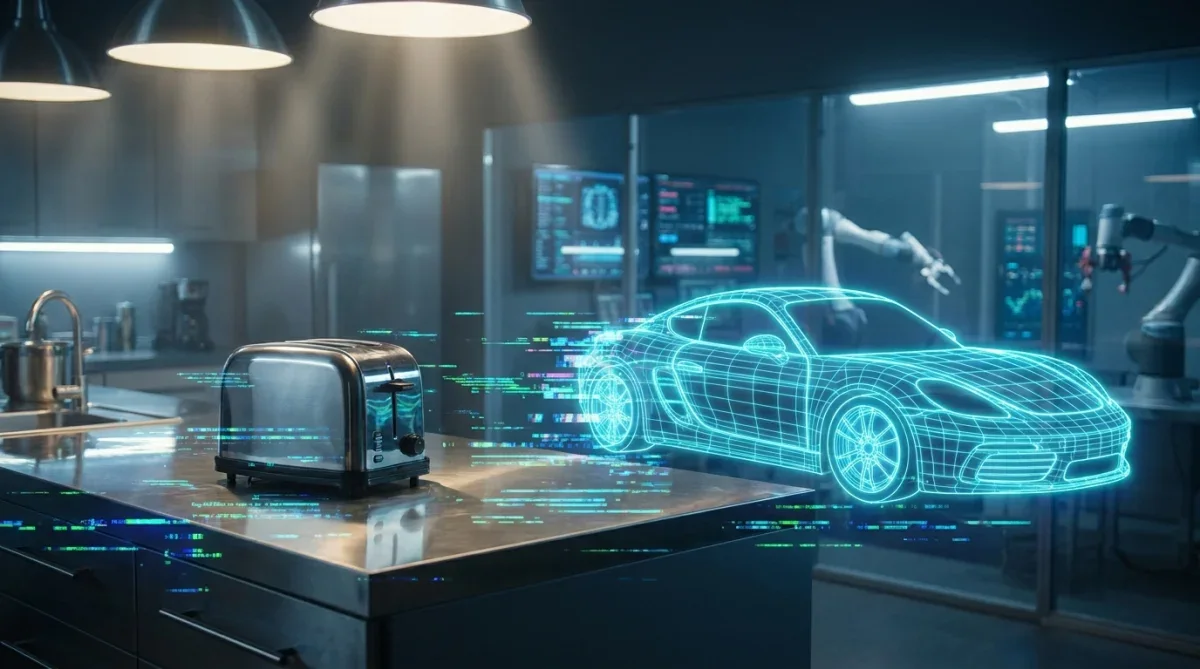
Em 2015, experimentos de visão computacional revelaram que pequenas perturbações em pixels faziam modelos avançados confundirem uma simples torradeira com um carro, inaugurando a era dos ataques adversariais na inteligência artificial.
Você confiaria a sua segurança a um sistema inteligente que olha para uma torradeira comum de cozinha e jura com absoluta certeza matemática de que se trata de um carro esportivo? Por volta de 2015, o avanço meteórico do reconhecimento de objetos por IA enfrentou exatamente essa situação desconcertante, abrindo os olhos da comunidade científica para vulnerabilidades profundas escondidas nas entranhas das redes neurais.
A ilusão da perfeição na visão computacional da época
Durante a primeira metade da década passada, o universo da ciência da computação vivia um momento de puro encantamento com o aprendizado profundo. As redes neurais convolucionais haviam quebrado recordes históricos em competições de prestígio internacional, como o desafio ImageNet, superando com folga os métodos tradicionais de processamento de imagens.
Grandes laboratórios acadêmicos e gigantes da tecnologia celebravam taxas de precisão que pareciam rivalizar com a própria visão biológica. Parecia apenas uma questão de meses até que sistemas autônomos pudessem navegar pelas ruas e diagnosticar exames médicos sem qualquer intervenção humana. No entanto, essa confiança generalizada estava prestes a colidir com uma realidade bem mais complexa e inquietante.
O otimismo desmedido dos primeiros benchmarks
Os testes padrão aplicados aos algoritmos costumavam avaliar o desempenho com base em conjuntos de dados estáticos, onde as fotos eram nítidas, bem iluminadas e centralizadas. Sob essas condições ideais de laboratório, as máquinas pareciam infalíveis, identificando com rapidez milhares de categorias distintas de itens cotidianos.
Essa aparente perfeição mascarava uma lacuna teórica grave: os cientistas compreendiam a arquitetura matemática das redes, mas tinham pouca visibilidade sobre como cada neurônio virtual tomava decisões contextuais diante de pequenas anomalias. Esse cenário gerava uma falsa sensação de segurança entre os desenvolvedores.
- Recordes sucessivos na classificação de milhões de imagens fotográficas em bancos de dados públicos.
- Adoção acelerada de bibliotecas de aprendizado profundo por startups e indústrias emergentes.
- Crença generalizada de que as redes neurais interpretavam imagens da mesma forma que o córtex visual humano.
- Ausência de metodologias robustas para testar o comportamento dos modelos sob ataques intencionais.
Assim, a euforia inicial acabou criando um ambiente vulnerável, onde a busca por métricas altas de acerto ofuscou a necessidade de entender a resiliência real dos sistemas frente a distorções visuais imprevisíveis.
O experimento que abalou a confiança dos cientistas
O ponto de virada ocorreu quando grupos de pesquisadores, liderados por nomes influentes no estudo de aprendizado de máquina, decidiram investigar os limites da robustez dos algoritmos. Eles começaram a manipular imagens de maneiras minuciosas para verificar se pequenas alterações causariam impacto perceptível nas predições das máquinas.
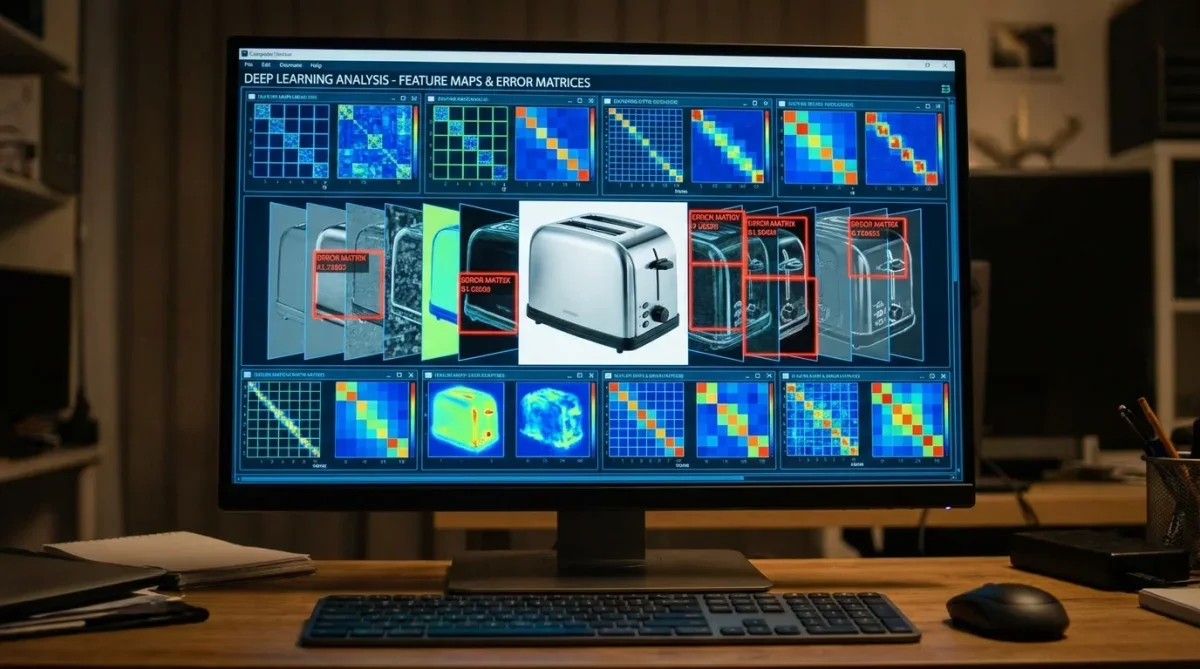
Foi nesse contexto que surgiu a famosa demonstração em que eletrodomésticos banais, como torradeiras cromadas, eram classificados com mais de noventa por cento de confiança como veículos automotores ou animais exóticos após a inserção de ruídos digitais imperceptíveis ao olho humano.
Para um observador de carne e osso, a fotografia continuava sendo inegavelmente a de um aparelho doméstico sobre a bancada. Para a máquina, entretanto, a combinação exata de valores de luminância e contraste em determinados pixels ativava circuitos internos associados a rodas, para-brisas e carrocerias metálicas.
O episódio gerou calafrios imediatos na comunidade científica porque não se tratava de uma mera falha aleatória ou de uma foto de baixa qualidade. O erro havia sido provocado por uma técnica metódica, capaz de enganar qualquer arquitetura baseada em gradientes matemáticos sem levantar qualquer suspeita visual.
Esse experimento prático demonstrou com clareza cristalina que a máquina não enxergava objetos no sentido semântico da palavra, mas apenas computava correlações estatísticas frágeis que podiam ser facilmente desvirtuadas por operadores maliciosos.
Como funcionam os ataques adversariais na prática
Para compreender como uma torradeira vira um carro na mente digital, é essencial destrinchar o conceito técnico conhecido como exemplo adversarial. Trata-se de uma entrada especialmente modificada para induzir um algoritmo de aprendizado de máquina a tomar uma decisão incorreta de maneira previsível e controlada.
Os pesquisadores utilizam cálculos de gradiente para descobrir exatamente quais pixels devem ser alterados, e em qual intensidade mínima, para empurrar a representação vetorial da imagem através da fronteira de decisão do classificador estatístico.
O mecanismo por trás da perturbação imperceptível
A matemática por trás desse fenômeno envolve a adição de uma camada de ruído calculada milimetricamente. Esse ruído é tão sutil que, quando misturado à imagem original, a diferença na escala de cores RGB é completamente invisível para a retina humana.
Enquanto o cérebro humano sintetiza formas globais, iluminação, sombras e semântica de contexto para reconhecer uma torradeira, a rede neural processa tensores numéricos camada por camada, somando pequenas alterações lineares que se acumulam exponencialmente até inverter o resultado final.
- Cálculo do vetor de gradiente baseado na função de perda da rede neural avaliada.
- Aplicação de pequenas variações direcionadas nos canais de cor de cada pixel estratégico.
- Preservação integral da aparência estética da imagem para observadores humanos.
- Mudança drástica da probabilidade estatística calculada nas camadas de saída do modelo.
Essa mecânica elegante e perturbadora provou que sistemas de aprendizado profundo operam com representações de dados altamente não lineares e desprovidas de qualquer senso comum estrutural ou raciocínio físico sobre o mundo real.
O abismo entre a visão biológica e as redes neurais artificiais
O erro da torradeira serviu como um poderoso banho de água fria sobre a analogia simplista entre o cérebro humano e as redes neurais artificiais. Embora inspiradas vagamente na biologia, as camadas de convolução não replicam a robustez do córtex visual primário e secundário.
A visão humana é inerentemente ativa, integrando memórias passadas, física intuitiva e expectativas espaciais para construir uma cena mental estável. Já os modelos computacionais são estáticos e excessivamente dependentes de texturas superficiais e padrões locais de alta frequência.
Estudos subsequentes revelaram que, enquanto os seres humanos priorizam silhuetas e estruturas geométricas para categorizar objetos, os classificadores automáticos prestam uma atenção desproporcional a texturas repetitivas. Se você colar a textura de pele de leopardo sobre a lataria de um ônibus, a IA terá forte tendência a rotular o ônibus como um felino selvagem.
Essa discrepância profunda explica por que perturbações minúsculas, capazes de alterar a textura matemática sem mexer no contorno macroscópico do objeto, desmoronam todo o castelo de cartas das predições computacionais.
Em última análise, a falha histórica de 2015 forçou a indústria a reconhecer que alta acurácia estatística em testes fechados não equivale a inteligência visual verdadeira ou compreensão cognitiva autêntica.
As implicações para a segurança de sistemas autônomos
Se o equívoco entre um eletrodoméstico e um automóvel parecia cômico à primeira vista, suas ramificações no mundo real acenderam sinais de alerta máximo em setores críticos da economia e da infraestrutura global.
A indústria automotiva, que investia bilhões de dólares no desenvolvimento de veículos totalmente autônomos, percebeu que um adesivo colorido colado em uma placa de trânsito poderia transformar um sinal de pare obrigatório em uma indicação de limite de velocidade livre.
Riscos críticos identificados em aplicações do cotidiano
Pesquisadores de segurança começaram a criar ataques adversariais no mundo físico, demonstrando que não era necessário invadir o software do veículo para manipulá-lo; pequenas intervenções no ambiente físico eram suficientes para enganar as câmeras.
Esse risco se estendeu rapidamente para sistemas de vigilância pública, controle de fronteiras por biometria facial e diagnósticos médicos automatizados, onde falsos positivos ou falsos negativos podem custar vidas humanas preciosas.
- Manipulação de placas de sinalização viária com pequenos adesivos quase invisíveis aos motoristas.
- Camuflagem de pedestres contra sensores visuais de carros autônomos por meio de estampas especiais em roupas.
- Burlar catracas de reconhecimento facial com armações de óculos pintadas com padrões matemáticos adversariais.
- Indução de diagnósticos médicos errôneos através de ruídos em imagens de ressonância magnética e tomografia.
Diante desse panorama preocupante, a robustez adversarial tornou-se uma das áreas mais urgentes de pesquisa dentro da ciência da computação contemporânea, deixando de ser um mero tópico de curiosidade acadêmica.
Como os engenheiros tentaram blindar os modelos ao longo dos anos
A descoberta desse calcanhar de Aquiles desencadeou uma verdadeira corrida armamentista entre pesquisadores focados em segurança defensiva e especialistas em criação de ataques cada vez mais sofisticados.
Diversas abordagens foram propostas para tentar imunizar as redes neurais contra perturbações adversariais, desde o retreinamento com dados corrompidos até a modificação radical das funções matemáticas utilizadas nas camadas internas.
Uma das técnicas mais populares é o chamado treinamento adversarial, no qual os engenheiros geram deliberadamente milhares de imagens manipuladas durante o processo de aprendizado, ensinando o modelo a ignorar ruídos e focar nas características essenciais do objeto.
Entretanto, essa solução não é uma bala de prata. O treinamento adversarial consome imenso poder computacional e frequentemente reduz a acurácia geral do sistema em imagens limpas e não manipuladas, criando um dilema permanente entre precisão bruta e segurança defensiva.
Outras estratégias incluem a fusão sensorial, combinando câmeras ópticas com sensores de radar, lidar e ultrassom para evitar que a ilusão de um único canal visual comprometa todo o processo de tomada de decisão de uma máquina autônoma.
Mesmo com todos esses avanços significativos ao longo da última década, a comunidade de inteligência artificial admite abertamente que a blindagem total e absoluta contra ataques adversariais continua sendo um problema em aberto sem solução definitiva.
| Ponto Chave | Descrição Resumida |
|---|---|
| O Incidente de 2015 | Redes neurais profundas classificaram uma torradeira como um carro após perturbações visuais mínimas. |
| Exemplos Adversariais | Modificações milimétricas em pixels imperceptíveis a humanos que alteram completamente o output da IA. |
| Impacto na Segurança | Sistemas de carros autônomos, reconhecimento facial e diagnósticos médicos exigiram novos protocolos de defesa. |
| Desafio em Aberto | A busca por robustez estrutural e fusão sensorial permanece como prioridade ativa na visão computacional moderna. |
O legado duradouro de uma torradeira na história da tecnologia
A bizarra confusão visual ocorrida em 2015 não foi apenas uma anedota divertida para entreter programadores em conferências científicas; ela funcionou como o catalisador que transformou para sempre a forma como pensamos a segurança no reconhecimento de objetos por IA. Graças a esse choque de realidade, a comunidade global aprendeu a olhar para além das pontuações infladas de acurácia em tabelas de teste, construindo arquiteturas mais resilientes, céticas e preparadas para lidar com o mundo caótico em que vivemos.