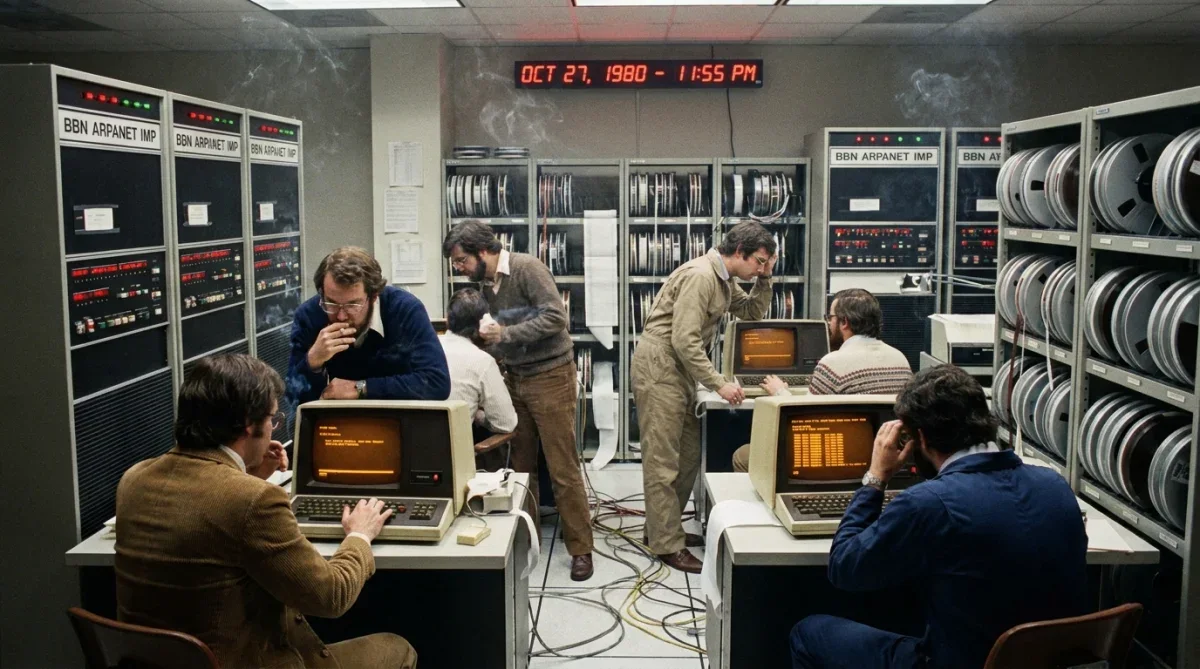
Em 27 de outubro de 1980, uma falha na integridade de mensagens de roteamento sobrecarregou os processadores da rede precursora da internet, paralisando todas as transmissões de dados em âmbito nacional por várias horas consecutivas.
Você já imaginou o que aconteceria se a internet inteira simplesmente congelasse em questão de minutos? No dia 27 de outubro de 1980, o colapso da ARPANET em 1980 transformou esse pesadelo em realidade pela primeira vez na história da computação moderna.
A estrutura pioneira da ARPANET antes da grande pane
No final da década de 1970 e início dos anos 1980, a ARPANET ainda era um projeto financiado pelo Departamento de Defesa dos Estados Unidos. A rede interligava universidades de elite, laboratórios de pesquisa militar e centros de computação avançada espalhados por todo o território norte-americano.
Essa estrutura experimental funcionava por meio de computadores dedicados conhecidos como IMPs (Interface Message Processors), considerados os primeiros roteadores da história da tecnologia digital.
O papel fundamental dos IMPs na comunicação
Os IMPs eram computadores robustos baseados na arquitetura Honeywell, desenhados para suportar condições severas e garantir que os pacotes de dados encontrassem o melhor caminho possível até o seu destino final.
Cada nó da rede executava algoritmos de roteamento dinâmico que atualizavam periodicamente o estado das conexões para redirecionar o tráfego em caso de falha de hardware ou corte de cabos.
- Processamento dedicado exclusivamente ao tráfego de pacotes entre centros de pesquisa.
- Atualização periódica de tabelas de roteamento para evitar rotas congestionadas.
- Priorização de mensagens de controle do sistema sobre o tráfego regular de usuários.
- Capacidade de operar de forma autônoma sem supervisão humana constante.
Essa arquitetura descentralizada era considerada praticamente indestrutível contra interrupções externas ou falhas isoladas de hardware, o que tornava a rede o projeto mais sofisticado de sua época.
O gatilho do desastre: o erro de memória que gerou mensagens fantasmas
Tudo começou de maneira aparentemente inofensiva no nó 29 da rede, localizado na Universidade de Utah. Um pequeno problema elétrico em um módulo de memória RAM corrompeu alguns bits de uma mensagem de status de roteamento que estava prestes a ser transmitida.
Em sistemas digitais primitivos, pequenos desvios de corrente ou degradações de componentes podiam inverter o valor de um bit de zero para um sem disparar alarmes imediatos.
O IMP corrompido gerou duas versões conflitantes da mesma mensagem de estado de enlace, cada uma com números de sequência alterados que o código de controle não soube interpretar corretamente.
Em vez de descartar os pacotes corrompidos, a rotina de software considerou que ambas as mensagens eram as mais recentes possíveis, criando uma contradição lógica insustentável dentro da fila de processamento da máquina.
Como consequência dessa anomalia, o nó começou a enviar atualizações conflitantes para todos os seus vizinhos diretos, iniciando um efeito dominó que se espalharia por toda a infraestrutura da ARPANET.
A tempestade perfeita de alta prioridade e consumo de processamento
O software dos IMPs continha uma regra de projeto bem-intencionada: mensagens de roteamento e diagnóstico tinham prioridade absoluta sobre qualquer outro tipo de dado que trafegasse pela rede.
Isso significava que, sempre que um pacote de controle chegava a um roteador, o processador interrompia o processamento de e-mails, arquivos e comandos remotos para processar a rota imediatamente.
A armadilha do processamento infinito
Quando os nós vizinhos receberam as mensagens corrompidas de Utah, seus próprios softwares entraram no mesmo loop lógico, gerando ainda mais pacotes de atualização de status com prioridade máxima.
Em poucos minutos, a capacidade computacional de cada IMP foi completamente sequestrada pelo tratamento incessante dessas mensagens de emergência fabricadas pelo bug.
- Esgotamento instantâneo da memória de buffer destinada a dados de usuários.
- Ocupação de 100% dos ciclos de CPU dos roteadores primitivos.
- Descarte massivo de pacotes de comunicação regulares entre as universidades.
- Propagação exponencial do tráfego inválido para todos os nós conectados.
A prioridade máxima concedida às mensagens de sistema transformou o mecanismo de autorrecuperação da rede na própria arma que causou sua paralisia completa.
O apagão completo e a corrida contra o tempo na BBN
Às 13h22 daquela segunda-feira, a ARPANET deixou de responder em sua totalidade. Os cientistas que trabalhavam em projetos de defesa e pesquisas acadêmicas perderam o acesso instantâneo aos seus terminais remotos.
Na sede da Bolt, Beranek and Newman (BBN) em Cambridge, Massachusetts — empresa responsável pela operação técnica da rede —, as telas de monitoramento começaram a apagar uma após a outra.
Os engenheiros da BBN perceberam rapidamente que não se tratava de uma falha local de cabos ou de uma tempestade regional, mas de um colapso sistêmico sem precedentes em escala continental.
Como a própria rede de comunicação estava inacessível, os técnicos não conseguiam enviar comandos remotos de depuração nem atualizar o firmware dos roteadores à distância.
A única alternativa viável foi recorrer a telefonemas convencionais para operadores e cientistas locais em cada uma das dezenas de instituições conectadas pelo país.
A operação de resgate: reinicialização manual nó por nó
Para recuperar a rede, a equipe da BBN precisou orquestrar um procedimento cirúrgico e demorado que exigiu a cooperação de dezenas de profissionais em fusos horários diferentes.
Cada nó precisava ser desligado fisicamente, ter sua memória limpa e ser religado em uma sequência estritamente coordenada para evitar que o tráfego residual reinfectasse as máquinas recuperadas.
Os passos da recuperação manual
A equipe técnica desenvolveu um protocolo de emergência para garantir que os IMPs voltassem a operar de maneira segura e isolada antes de restabelecer os links de longa distância.
Operadores em cada universidade precisaram intervir diretamente nos painéis frontais dos computadores, acionando chaves manuais para reiniciar os sistemas operacionais embarcados.
- Desconexão física dos cabos de transmissão serial de dados entre os centros de pesquisa.
- Reinicialização a frio (power cycle) dos computadores IMP para purgar memórias voláteis.
- Carregamento de versões limpas do software básico a partir de fitas magnéticas ou discos locais.
- Reconexão gradual e monitorada dos enlaces geográficos partindo do núcleo em Massachusetts.
Após quase quatro horas de tensão ininterrupta e coordenação telefônica, o tráfego regular finalmente começou a fluir novamente, encerrando o primeiro grande blecaute da história da internet.
O impacto do incidente na evolução dos protocolos de rede
O colapso de 1980 serviu como um divisor de águas na engenharia de software e na arquitetura de telecomunicações mundiais. O incidente provou que confiar cegamente na integridade dos dados sem mecanismos robustos de verificação era um risco inaceitável.
A comunidade de desenvolvedores percebeu que falhas minúsculas de hardware poderiam desencadear reações catastróficas em sistemas distribuídos complexos.
Nos meses seguintes ao evento, os engenheiros da BBN reescreveram o código de roteamento, implementando checagens rigorosas de paridade, checksums avançados e limites rígidos para o tempo de vida dos pacotes de controle.
Além disso, o episódio acelerou a transição definitiva para a suíte de protocolos TCP/IP, oficializada em 1983, que trouxe camadas de abstração mais seguras e mecanismos inteligentes de contenção de congestionamento.
Sem as lições aprendidas naquele dia fatídico de outubro, a arquitetura da internet moderna certamente não possuiria a resiliência necessária para suportar os bilhões de dispositivos conectados que utilizamos atualmente.
| Aspecto Central | Detalhes do Evento de 1980 |
|---|---|
| Origem da Falha | Corrupção de bits na memória RAM do nó 29 na Universidade de Utah. |
| Mecanismo de Propagação | Mensagens conflitantes de roteamento com prioridade máxima de processamento. |
| Tempo de Inatividade | Aproximadamente quatro horas de paralisia total em escala nacional. |
| Legado Técnico | Criação de checksums rígidos e aceleração da adoção dos protocolos TCP/IP. |
Conclusão
O primeiro grande apagão da história da tecnologia revelou que a robustez de uma rede não depende apenas da força física de seus cabos, mas da elegância defensiva de seus códigos. O episódio de 1980 permanece como um lembrete fascinante sobre como pequenos descuidos de programação e detalhes de hardware moldaram as bases da internet resiliente que move a sociedade contemporânea.