Um erro microscópico de lógica e sintaxe em uma atualização de software da AT&T derrubou metade das linhas telefônicas de longa distância dos Estados Unidos em 15 de janeiro de 1990, bloqueando mais de 75 milhões de chamadas durante nove horas de caos absoluto.
Você já imaginou pegar o telefone para fazer uma ligação de emergência, confirmar uma viagem aérea ou fechar um negócio crucial e simplesmente ouvir um tom de ocupado perpétuo? Em 15 de janeiro de 1990, o lendário bug da AT&T em 1990 transformou esse pesadelo em realidade para dezenas de milhões de cidadãos norte-americanos, provando que um único caractere mal posicionado em um programa de computador pode paralisar uma superpotência moderna.
O cenário das telecomunicações em 1990 e a hegemonia da AT&T
Na virada da década de 1990, a American Telephone and Telegraph (AT&T) representava o ápice indiscutível da engenharia de redes no planeta. Seus laboratórios, o mítico Bell Labs, haviam inventado o transistor, o sistema operacional Unix e a linguagem de programação C, estabelecendo os próprios alicerces sobre os quais toda a computação digital moderna foi construída.
A infraestrutura de longa distância da empresa gerenciava centenas de milhões de chamadas diárias através de uma malha sofisticada de centrais computadorizadas. Essas centrais, conhecidas como comutadores 4ESS (Electronic Switching System), eram computadores gigantescos de altíssima confiabilidade projetados para operar quase sem interrupções humanas.
A busca por velocidade máxima nas conexões
Para manter sua liderança e acomodar a demanda crescente por dados e voz, a AT&T implementou uma modernização agressiva em seu protocolo de sinalização. O objetivo principal era reduzir o tempo de estabelecimento de cada chamada em frações preciosas de segundo, liberando troncos telefônicos instantaneamente.
Essa arquitetura utilizava o protocolo SS7 (Signaling System No. 7), que separava os dados de controle da voz propriamente dita em canais dedicados. Essa inovação trouxe ganhos gigantescos de velocidade e capacidade, mas também criou uma teia de interdependência onde uma mensagem de status de uma central afetava diretamente todas as suas vizinhas.
- Modernização de 114 comutadores centrais em todo o território dos Estados Unidos;
- Implementação do sistema SS7 para roteamento ultrarrápido de dados de sinalização;
- Automação completa dos protocolos de recuperação de falhas e redefinição de circuitos;
- Convicção corporativa de que a redundância de hardware tornava a rede imune a apagões totais.
A confiança da diretoria e dos engenheiros na robustez do sistema era irrestrita, sustentada por décadas de estabilidade invejável. Mal sabiam eles que a transição para sistemas distribuídos altamente acoplados guardava vulnerabilidades conceituais que nenhum teste de bancada tradicional havia conseguido detectar.
A anatomia do erro: uma única instrução em linguagem C
Em meados de dezembro de 1989, a equipe de desenvolvimento da AT&T finalizou uma atualização de software destinada a aprimorar o processamento de mensagens de sinalização nos comutadores 4ESS. O novo código prometia tornar a rede ainda mais ágil na recuperação de pequenas falhas rotineiras.
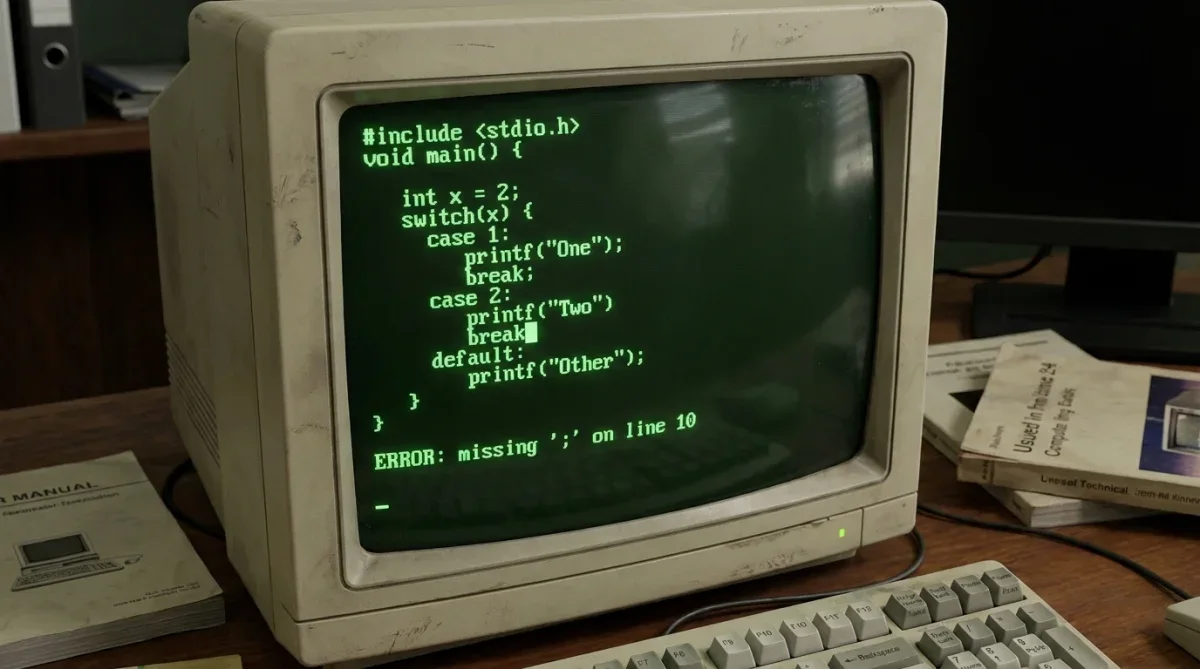
No entanto, escondida entre milhares de linhas de código escritas em linguagem C, repousava uma falha de lógica elementar. O problema ocorreu em um bloco condicional aninhado dentro de uma instrução de seleção de casos (estrutura switch-case), onde um comando de desvio foi colocado no local errado.
O mecanismo da instrução break mal posicionada
Em linguagem C, a declaração break possui uma função muito clara: ela encerra a execução do laço de repetição ou do bloco condicional switch mais próximo. Quando colocada incorretamente dentro de uma cláusula if contida num switch, ela não sai do if, mas sim de todo o switch.
Foi exatamente o que aconteceu: o programador pretendia apenas tratar uma condição temporária de erro de dados, mas o comando break causou a saída prematura da rotina principal de inicialização de ponteiros. Com isso, variáveis fundamentais de memória foram sobrescritas com lixo eletrônico antes que o processo estivesse concluído.
O resultado dessa construção defeituosa pode ser compreendido nos seguintes pontos técnicos:
- O processador recebia uma mensagem de retorno de serviço enviada por uma central vizinha;
- A rotina tentava ler os dados de buffer enquanto o ponteiro de memória ainda estava corrompido;
- O software interpretava a memória corrompida como uma falha catastrófica de integridade interna;
- O sistema operacional do comutador disparava um reinício forçado de proteção para salvar seus circuitos.
Em condições isoladas de teste de laboratório, essa sequência de eventos exigia uma sincronia de microssegundos que nunca havia ocorrido durante as validações prévias. O software defeituoso foi aprovado nos testes e instalado em todos os 114 comutadores nacionais sem levantar qualquer suspeita.
O efeito dominó que paralisou 114 centrais telefônicas
O drama começou oficialmente às 14h25 da segunda-feira, 15 de janeiro de 1990, um feriado nacional em homenagem a Martin Luther King Jr. Uma central de comutação na cidade de Nova York registrou uma sobrecarga passageira e executou um procedimento de reinicialização de rotina de quatro segundos.
Ao reiniciar com sucesso, a central novaiorquina enviou uma mensagem padrão de sinalização SS7 para suas centrais conectadas, avisando que estava novamente apta a receber chamadas. Foi o estopim necessário para que a catástrofe começasse a se propagar em velocidade eletrônica.
A reação em cadeia dos comutadores vizinhos
Uma central vizinha em White Plains, Nova York, recebeu esse pacote de comunicação enquanto ainda estava finalizando o processamento de outra chamada. Esse choque de temporização ativou o fragmento defeituoso de código C, fazendo com que a central de White Plains falhasse e reiniciasse imediatamente.
Quando White Plains voltou a operar segundos depois, enviou o mesmo aviso de prontidão para outras centrais, que por sua vez falharam e reiniciaram. Em questão de minutos, um ciclo vicioso de reinicializações cruzadas varreu todo o território dos Estados Unidos de costa a costa.
Esse mecanismo de colapso coletivo revelou características alarmantes do sistema:
- Cada máquina que tentava ajudar sua vizinha acabava sendo infectada pela lógica de falha;
- A rede inteira entrou em uma oscilação perpétua de reinicializações sincronizadas;
- Cerca de metade de todas as centrais 4ESS do país ficaram presas em loops contínuos de reinício;
- A capacidade operacional da infraestrutura de longa distância despencou para menos de 50%.
O protocolo que havia sido concebido justamente para conferir resiliência e autorrecuperação à malha de comunicações transformou-se no vetor perfeito para a transmissão de um colapso em cadeia sem precedentes na história industrial.
Impacto real: aeroportos, bancos e milhões de chamadas perdidas
Durante as nove horas em que o sistema esteve desgovernado, o cotidiano e a economia dos Estados Unidos sofreram um baque estarrecedor. Estima-se que mais de 75 milhões de chamadas interurbanas simplesmente não puderam ser completadas durante a tarde e a noite daquele fatídico dia.
Como a AT&T dominava mais de dois terços do mercado de longa distância na época, o colapso de suas centrais isolou cidades inteiras, separou famílias em pleno feriado e congelou transações corporativas críticas em escala continental.
O caos nos setores de transporte e serviços essenciais
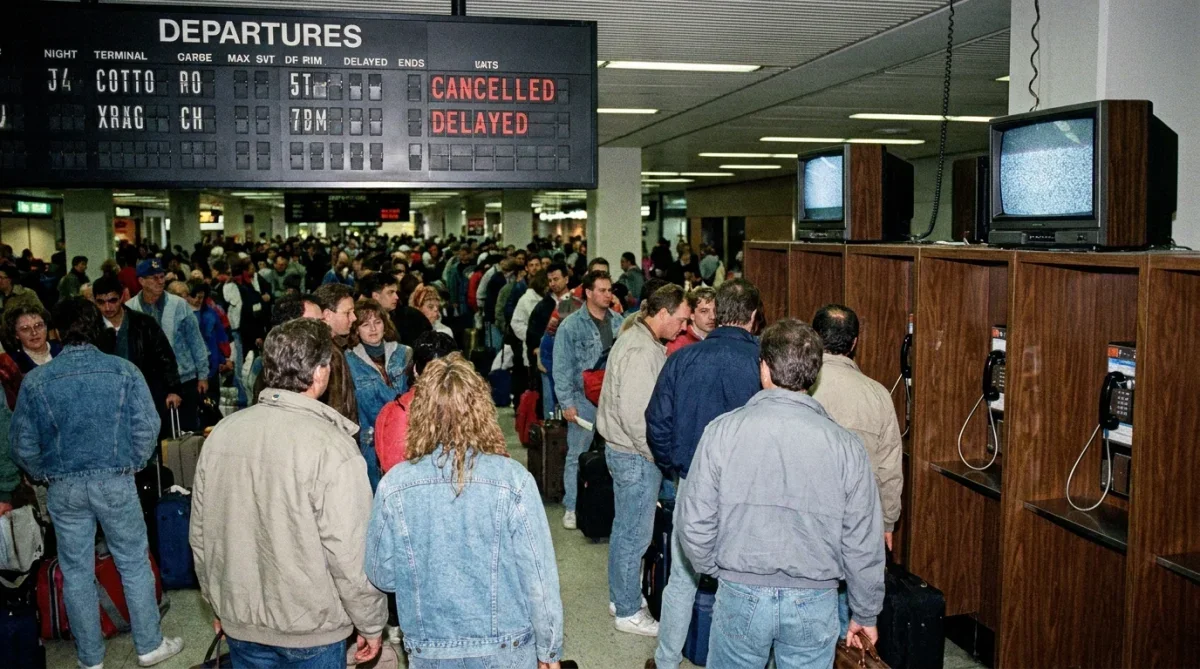
O setor aéreo foi um dos mais castigados pela pane. Companhias aéreas de grande porte, como a American Airlines e a Delta, dependiam das linhas dedicadas da AT&T para seus sistemas centrais de reserva de passagens e liberação de planos de voo.
Em poucos minutos, os balcões de atendimento dos aeroportos de Nova York, Chicago, Atlanta e Los Angeles viram-se completamente paralisados, incapazes de emitir bilhetes ou consultar assentos disponíveis. Filas quilométricas formaram-se diante dos raros telefones públicos de operadoras locais concorrentes.
- Mais de 500 voos comerciais sofreram atrasos severos ou cancelamentos imediatos em todo o país;
- Centrais de atendimento de cartões de crédito e serviços bancários interromperam autorizações;
- Linhas telefônicas de emergência e hospitais enfrentaram instabilidade para contatar especialistas;
- Grandes redes de hotéis e locadoras de veículos perderam dezenas de milhares de reservas de clientes.
O impacto financeiro direto e indireto para as empresas ultrapassou a casa de centenas de milhões de dólares, além de abalar profundamente a confiança pública na infalibilidade dos sistemas de comunicação eletrônica.
O mistério da causa: ataque cibernético ou falha humana?
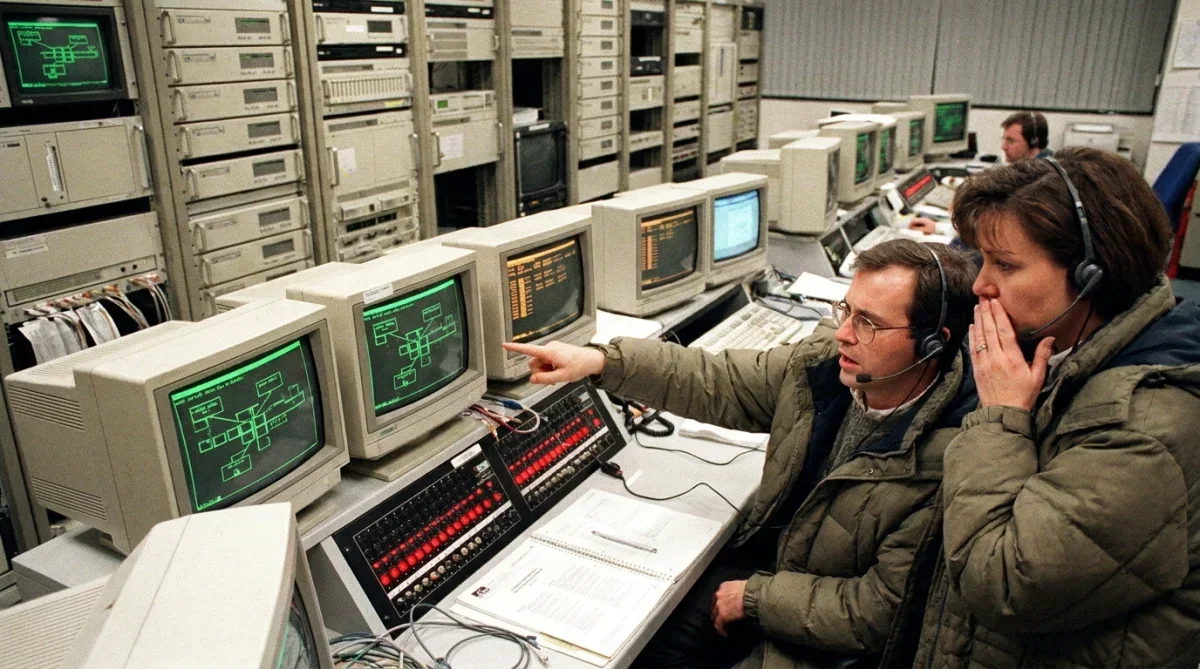
Nas primeiras horas da crise, o clima dentro da sala de controle de operações de rede da AT&T em Bedminster, Nova Jersey, era de pânico e perplexidade total. Ninguém conseguia compreender como dezenas de computadores industriais independentes estavam caindo simultaneamente.
A hipótese inicial mais temida pela cúpula de segurança nacional foi a de uma sabotagem premeditada. Com a Guerra Fria ainda fresca na memória coletiva e o surgimento recente dos primeiros vírus de computador, especulou-se abertamente sobre uma ação de hackers ou de agentes estrangeiros hostis.
A corrida contra o tempo dos engenheiros de software
Equipes de elite do Bell Labs foram mobilizadas às pressas para examinar os despejos de memória (memory dumps) das centrais afetadas. Centenas de engenheiros analisaram minuciosamente o tráfego de dados à procura de pacotes maliciosos, comandos não autorizados ou vestígios de intrusão externa.
Conforme os registros eram decifrados, a verdade começou a emergir com clareza desconcertante: não havia nenhum hacker, nenhum vírus e nenhuma conspiração internacional. Tratava-se pura e exclusivamente de um erro de programação interno distribuído pela própria empresa em sua rotina regular de manutenção.
Os passos para a mitigação do problema envolveram medidas drásticas:
- Engenheiros enviaram comandos manuais para desativar temporariamente o processamento rápido do SS7;
- Reduziram propositalmente a carga de tráfego de entrada para que as centrais conseguissem respirar;
- Reverteram o software dos comutadores para a versão compilada estável anterior;
- Por volta das 23h30 daquela noite, a estabilidade de toda a malha de telecomunicações foi finalmente restabelecida.
O episódio serviu como um banho de água fria em uma indústria que frequentemente atribuía falhas de grande magnitude a fatores externos, forçando a liderança técnica a reconhecer suas próprias deficiências de governança.
Lições de engenharia de software e testes de sistemas críticos
O colapso da AT&T em 1990 tornou-se um divisor de águas permanente para a disciplina da ciência da computação. O caso passou a ser lecionado obrigatoriamente nas principais universidades do mundo como o exemplo definitivo de falha em sistemas complexos e distribuídos.
Antes desse incidente, a mentalidade predominante na indústria acreditava que testar componentes isoladamente em laboratório e confiar na redundância de equipamentos físicos bastava para garantir a sobrevivência de um ecossistema digital.
Novos paradigmas para atualização de código e resiliência
A catástrofe evidenciou o perigo letal de atualizar todos os nós de uma rede ao mesmo tempo. Se um software possui uma falha oculta e é instalado universalmente de uma só vez, a redundância de hardware torna-se completamente inútil, já que todas as máquinas falharão da mesma maneira.
A partir dessa constatação dolorosa, a indústria de tecnologia adotou práticas que hoje são consideradas padrões fundamentais de engenharia moderna:
- Implantações graduais (Canary Deployments): atualizações são liberadas primeiro em pequena fração de servidores;
- Testes de estresse sob condições reais de corrida: simulação de cargas extremas e concorrência de mensagens;
- Desacoplamento de sistemas: garantia de que a falha de um nó não force seus vizinhos a repetirem o mesmo erro;
- Revisão de código por múltiplos pares: inspeção rigorosa de estruturas lógicas antes de qualquer compilação.
Essas transformações metodológicas moldaram diretamente a forma como a internet, os servidores em nuvem modernos e os serviços que utilizamos diariamente em nossos smartphones são construídos para resistir a panes imprevistas.
| Aspecto Central | Detalhes do Incidente da AT&T (1990) |
|---|---|
| Origem Técnica | Instrução break mal posicionada dentro de cláusula if em linguagem C. |
| Escala do Impacto | 114 comutadores afetados, bloqueando mais de 75 milhões de ligações por 9 horas. |
| Mecanismo de Falha | Efeito cascata em protocolo SS7 com mensagens de recuperação corrompendo centrais vizinhas. |
| Legado para a Indústria | Criação de deploys graduais, isolamento de falhas e novos padrões de teste de estresse. |
Conclusão
A pane histórica de 1990 permanece como uma das histórias mais fascinantes e instrutivas de toda a era da computação. Ela nos lembra com extraordinária clareza que, por trás das maiores redes de comunicação e dos sistemas digitais que moldam o cotidiano da humanidade, cada caractere digitado por um programador carrega um peso monumental. Aprender com acidentes dessa magnitude permitiu que a infraestrutura moderna se tornasse incomparavelmente mais segura, madura e preparada para conectar o planeta com a estabilidade que hoje consideramos natural.